语音输入与播报
对话支持完整的语音闭环:语音提问(录音 → 自动转文字发送)与语音回答(TTS 播报)。两端可以独立开关,组合出「语音问、文字答」「文字问、语音答」等模式。
语音输入(录音提问)
- 点击输入栏的话筒图标,界面显示「点击开始对话」;
- 再次点击开始录音,图标区显示「对话中(N 秒)」;
- 结束时再次点击图标,录音自动结束并发送——无需再点发送按钮;
- 录音上传后由系统的语音识别(ASR)服务转为文字,作为提问发给 AI。
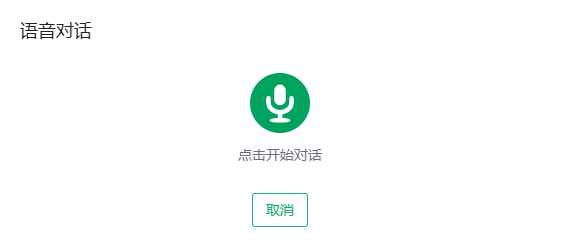
说明:
- 语音识别服务由系统管理员全局配置(同一时间只有一个 ASR 服务生效),用户无需也无法自行切换;
- 可识别的时长与文件大小上限由系统配置决定(如最长 60 秒),超时录音会自动截断;
- 转写结果即提问正文,发送前无法人工修正,识别偏差时可用文字重新提问。
语音播报(AI 回复)
在角色的进阶设置中控制:
| 设置 | 选项 | 说明 |
|---|---|---|
| AI 回复内容格式 | 自动 / 文字 / 语音 | 「自动」表示跟随你的输入格式:语音提问则语音回答 |
| 自动播放回复语音 | 开 / 关 | 回答到达后是否自动播放音频 |
| 音色选择 | 下拉列表 | 服务端 TTS 时可选;浏览器端合成则无需指定 |
收到语音回答后,可点击显示文字 / 显示音频在文本与音频两种展示间切换——想核对内容看文字,想听效果放音频。
NOTE
TTS 服务同样由管理员全局配置。合成发生在服务端还是浏览器端取决于部署配置:浏览器端合成无需选择音色;两者听感与可用音色可能不同。
给开发者
为系统接入新的 ASR / TTS 平台属于开发工作,见开发文档中的语音识别(ASR)能力接入与语音合成(TTS)能力接入。